


انتخاب و کانفیگ سرور HP برای هوش مصنوعی؛ راهنمای کامل خرید
اگر برای هوش مصنوعی قصد خرید سرور دارید، انتخاب GPU، مقدار VRAM، CPU، RAM، Storage و حتی توان مصرفی و سیستم خنکسازی باید متناسب با نوع workload انجام شود.
پروژههای هوش مصنوعی به زیرساختی نیاز دارند که بتواند حجم بالای داده و محاسبات سنگین را با سرعت و پایداری مناسب پردازش کند. انتخاب سرور مناسب برای این پروژهها فقط به قدرت پردازنده محدود نمیشود و عواملی مانند GPU و مقدار حافظه آن (VRAM)، پردازنده، RAM، فضای ذخیرهسازی، شبکه، توان مصرفی و سیستم خنکسازی نیز باید متناسب با نوع کاربرد در نظر گرفته شوند.
در این راهنما، مهمترین معیارهای انتخاب و کانفیگ سرور HP برای هوش مصنوعی را بررسی میکنیم و توضیح میدهیم برای کاربردهایی مانند آموزش و اجرای مدلهای AI، پردازش تصویر و ویدئو، RAG، LLM و Fine-tuning به چه مشخصاتی نیاز دارید. همچنین چند نمونه کانفیگ مناسب را بررسی میکنیم تا بتوانید بر اساس نوع پروژه، حجم داده و بودجه، سرور HP مناسب برای خرید را انتخاب کنید.
چرا سرورهای HP برای هوش مصنوعی انتخاب مناسبی هستند؟
- قابلیت پشتیبانی از GPU: سرورهای HP با پردازندههای قدرتمند و کارتهای گرافیک اختصاصی (GPU)، توان محاسباتی بسیار بالایی را برای آموزش و اجرای مدلهای پیچیده AI فراهم میکنند.
- قابلیت توسعه و سفارشیسازی: این سرورها با توجه به نیازهای خاص هر سازمان قابل سفارشیسازی هستند و میتوان آنها را با اجزای مختلفی مانند حافظه، ذخیرهسازی و شبکه تجهیز کرد.
- قابلیت اطمینان: سرورهای HP به دلیل طراحی با کیفیت و استفاده از اجزای با دوام، از پایداری و قابلیت اطمینان بالایی برخوردار هستند و میتوانند به صورت ۲۴ ساعته و ۷ روز هفته در حال کار باشند.
- مدیریت و امنیت: سرورهای HPE ProLiant با قابلیتهایی مانند HPE iLO امکان مدیریت و پایش سرور از راه دور را فراهم میکنند و قابلیتهای امنیتی HPE نیز به محافظت از Firmware و زیرساخت سرور کمک میکنند.
- بهرهوری انرژی: مدیریت توان و طراحی حرارتی در سرورهای مجهز به GPU اهمیت زیادی دارد و باید متناسب با تعداد و نوع GPU بررسی شود.
اگر میخواهید با قابلیتها و نقش سرورهای اچ پی در پروژههای هوش مصنوعی بیشتر آشنا شوید، مقاله نقش سرور HP در هوش مصنوعی را مطالعه کنید.
نکاتی برای انتخاب سرور HP مناسب برای هوش مصنوعی
انتخاب سرور مناسب برای پروژههای هوش مصنوعی فقط به قدرت پردازنده یا تعداد GPUها محدود نمیشود. برای رسیدن به یک کانفیگ متناسب با نیاز پروژه، باید نوع بار کاری، اندازه مدل، حافظه، ذخیرهسازی، شبکه و امکان توسعه در آینده را نیز در نظر گرفت.
1. نوع Workload
اولین قدم، مشخص کردن نوع کاری است که سرور باید انجام دهد. نیازهای سختافزاری Training، Inference، Fine-tuning، RAG، Computer Vision، LLM و پردازش ویدئو با یکدیگر متفاوت هستند و انتخاب قطعات باید بر اساس نوع workload انجام شود.
2. اندازه و نوع مدل
هرچه مدل هوش مصنوعی بزرگتر و پیچیدهتر باشد، منابع پردازشی و حافظه بیشتری نیاز دارد. قبل از انتخاب سرور باید مشخص شود مدل موردنظر چه اندازهای دارد و قرار است بهصورت کامل یا با روشهایی مانند Fine-tuning روی سرور اجرا شود.
3. GPU مورد نیاز
GPU مهمترین بخش بسیاری از سرورهای AI است و تأثیر مستقیمی بر سرعت آموزش و اجرای مدلها دارد. انتخاب GPU باید بر اساس نوع workload، حجم محاسبات و تعداد GPU مورد نیاز انجام شود.
4. مقدار VRAM
ظرفیت VRAM تعیین میکند چه اندازه مدل و چه حجم دادهای را میتوان مستقیماً روی GPU پردازش کرد. برای مدلهای بزرگ، انتخاب GPU با VRAM کافی اهمیت زیادی دارد و کمبود آن میتواند عملکرد پردازش را محدود کند.
5. CPU
CPU وظایفی مانند آمادهسازی داده، اجرای سرویسها و هماهنگی با GPUها را بر عهده دارد. در پروژههای AI باید پردازندهای انتخاب شود که از نظر تعداد هسته، توان پردازشی و ارتباط با GPUها با workload موردنظر تناسب داشته باشد.
6. RAM
حافظه RAM برای بارگذاری دادهها، اجرای همزمان سرویسها و پردازشهای مرتبط با مدل اهمیت دارد. مقدار RAM باید متناسب با حجم داده، نوع workload و تعداد کاربران یا سرویسهای همزمان انتخاب شود.
7. Storage
سرعت و ظرفیت ذخیره سازی در پروژههای AI، بهویژه هنگام کار با دیتاستهای بزرگ، اهمیت زیادی دارد. استفاده از SSD یا NVMe با ظرفیت مناسب میتواند زمان دسترسی به داده و جابهجایی Dataset و Model را کاهش دهد.
8. کارت گرافیک
در محیطهایی که سرور به سیستمهای ذخیرهسازی، سرورهای دیگر یا چند GPU و نود پردازشی متصل است، سرعت شبکه اهمیت زیادی پیدا میکند. انتخاب کارت شبکه و پهنای باند مناسب باید بر اساس حجم انتقال داده و معماری زیرساخت انجام شود.
9. پاور
GPUهای قدرتمند و پردازندههای سروری میتوانند مصرف انرژی قابلتوجهی داشته باشند. بنابراین توان مصرفی کل کانفیگ باید پیش از خرید بررسی شود تا منبع تغذیه سرور و زیرساخت برق متناسب با آن انتخاب شود.
10. Cooling
پردازشهای سنگین AI میتوانند برای مدت طولانی بار زیادی روی CPU و GPU ایجاد کنند. به همین دلیل، قابلیت خنکسازی سرور و سازگاری آن با GPUهای انتخابشده باید هنگام طراحی کانفیگ مورد توجه قرار گیرد.
11. قابلیت توسعه در آینده
اگر احتمال افزایش حجم داده، اضافه شدن GPU یا ارتقای RAM و Storage وجود دارد، بهتر است سروری انتخاب شود که فضای کافی برای توسعه آینده داشته باشد. این موضوع میتواند از تعویض زودهنگام کل سرور جلوگیری کند.
12. بودجه
بودجه باید در کنار نیاز واقعی پروژه بررسی شود، نه بهعنوان تنها معیار انتخاب. هدف، انتخاب کانفیگی است که با توجه به workload، عملکرد موردنیاز و امکان توسعه آینده، بهترین توازن بین هزینه و کارایی را ارائه دهد.
سرور HPE برای چه کاربردهای هوش مصنوعی استفاده میشود؟
سرورهای HPE ProLiant میتوانند برای طیف متنوعی از پروژههای هوش مصنوعی مورد استفاده قرار گیرند. نوع کاربرد، یکی از مهمترین عوامل در تعیین کانفیگ مناسب سرور، بهویژه در انتخاب GPU، مقدار VRAM، CPU و RAM است.
LLM و Generative AI
برای اجرای مدلهای زبانی بزرگ و برنامههای مبتنی بر هوش مصنوعی مولد، معمولاً به GPUهای قدرتمند و VRAM کافی نیاز است. هرچه مدل بزرگتر باشد، نیاز به منابع پردازشی و حافظه بیشتری افزایش پیدا میکند.
Computer Vision
در پروژههای بینایی ماشین مانند تشخیص اشیا، تحلیل تصاویر و پردازش ویدئو، GPU میتواند بخش مهمی از محاسبات را بر عهده بگیرد. تعداد تصاویر، وضوح و حجم دادهها در انتخاب منابع سختافزاری مؤثر هستند.
Inference
Inference به مرحله اجرای مدل آموزشدیده برای تولید نتیجه گفته میشود. در این کاربرد، سرعت پاسخ، تعداد درخواستهای همزمان و اندازه مدل در تعیین GPU، VRAM و سایر منابع سرور اهمیت دارند.
Fine-tuning
در Fine-tuning، یک مدل از پیش آموزشدیده برای یک کاربرد یا مجموعه داده مشخص تنظیم میشود. بسته به اندازه مدل و روش Fine-tuning، ممکن است به GPU با VRAM بالا و منابع پردازشی قابلتوجه نیاز باشد.
RAG
در معماری RAG، مدل هوش مصنوعی برای پاسخگویی از اطلاعات موجود در منابع و پایگاههای داده استفاده میکند. در این محیطها علاوه بر GPU، CPU، RAM، Storage و سرعت شبکه نیز میتوانند در عملکرد کلی سیستم تأثیرگذار باشند.
پردازش تصویر و ویدئو
پردازش حجم بالای تصاویر و ویدئو، بهخصوص در کاربردهای Real-time، میتواند نیازمند توان پردازشی بالایی باشد. انتخاب منابع مناسب به حجم داده، رزولوشن و تعداد جریانهای همزمان بستگی دارد.
Machine Learning
در پروژههای یادگیری ماشین، سرور میتواند برای آموزش مدل، آمادهسازی داده، اجرای الگوریتمها و پیشبینی استفاده شود. نیاز سختافزاری این پروژهها به نوع مدل، حجم Dataset و روش پردازش بستگی دارد.
AI در محیطهای سازمانی
سازمانها میتوانند از سرورهای HPE برای اجرای مدلهای AI در محیط داخلی، تحلیل داده، اتوماسیون فرآیندها و سرویسهای هوشمند استفاده کنند. در این سناریوها علاوه بر عملکرد، امنیت، قابلیت مدیریت، پایداری و امکان توسعه زیرساخت اهمیت زیادی دارد.

اجزای اصلی کانفیگ سرور HP برای هوش مصنوعی
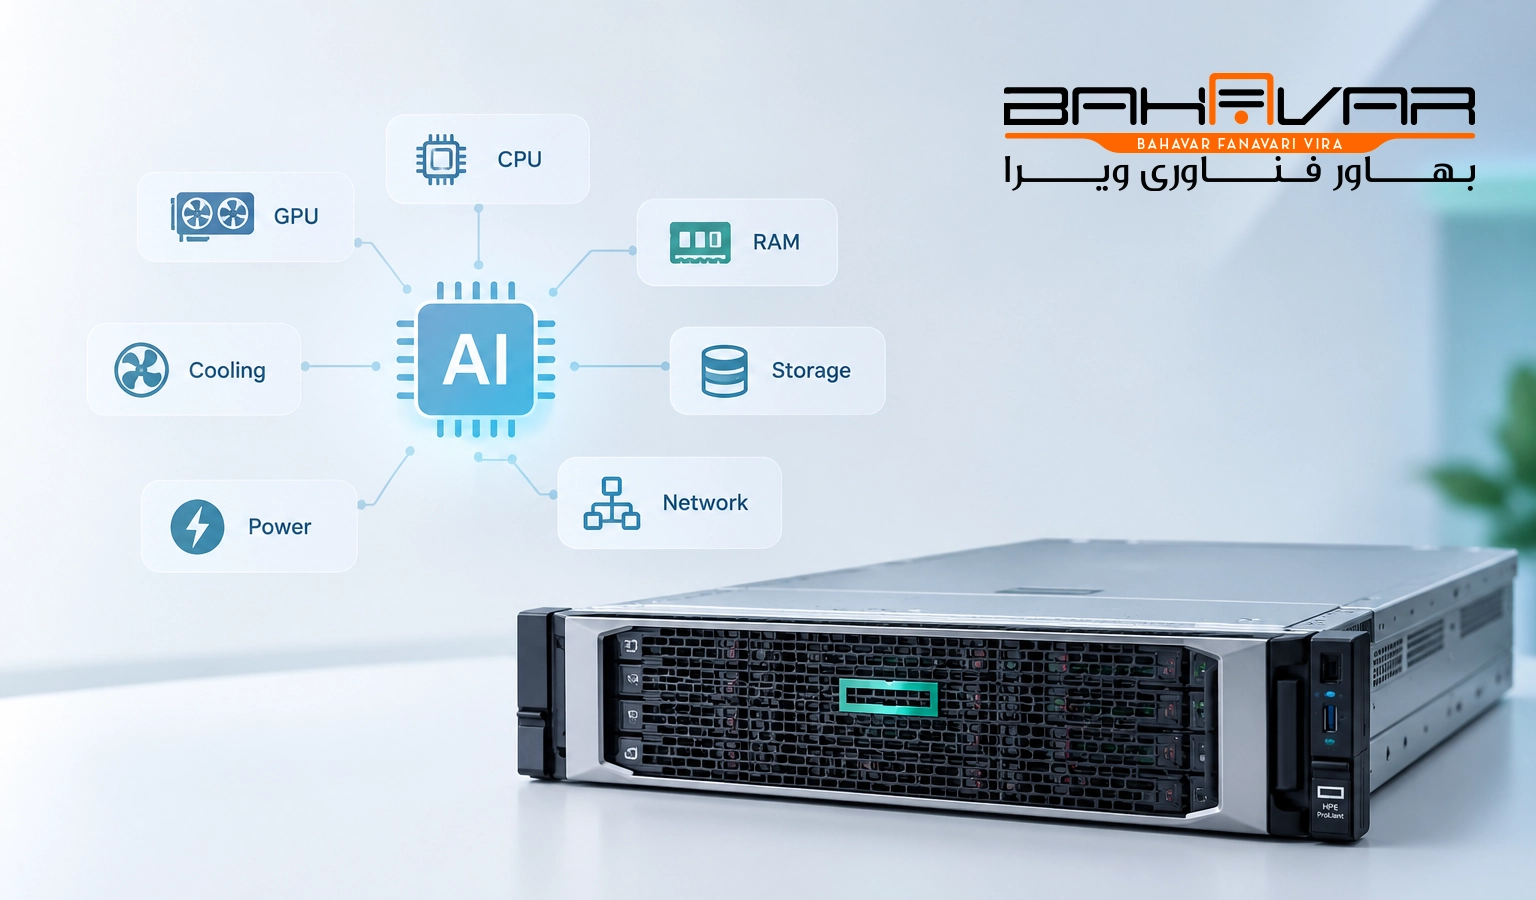
انتخاب کانفیگ مناسب برای سرور هوش مصنوعی به نوع workload، اندازه مدل و حجم داده بستگی دارد. در این میان، GPU و VRAM معمولاً بیشترین تأثیر را بر توان پردازشی AI دارند؛ اما CPU، RAM، Storage، Network، Power و Cooling نیز باید متناسب با یکدیگر انتخاب شوند تا سرور بتواند بار کاری موردنظر را بهصورت پایدار اجرا کند.
GPU؛ مهمترین بخش بسیاری از سرورهای AI
در بسیاری از پروژههای هوش مصنوعی، GPU اصلیترین بخش پردازشی سرور است؛ زیرا میتواند تعداد زیادی محاسبه را بهصورت موازی انجام دهد. آموزش مدلهای Deep Learning، اجرای مدلهای بزرگ، Computer Vision و برخی کاربردهای Inference به GPU قدرتمند نیاز دارند.
انتخاب GPU باید بر اساس نوع workload، اندازه مدل، تعداد کاربران و میزان پردازش موردنیاز انجام شود. در پروژههای سنگینتر نیز ممکن است استفاده از چند GPU در یک سرور ضروری باشد.
VRAM؛ چه مقدار حافظه GPU نیاز داریم؟
ظرفیت VRAM یکی از مهمترین مشخصات GPU برای پروژههای AI است. مدل، دادهها و بخشی از محاسبات باید در حافظه GPU قرار بگیرند؛ بنابراین اگر VRAM کافی نباشد، اجرای مدل یا آموزش آن میتواند با محدودیت مواجه شود.
برای مدلهای کوچکتر ممکن است GPU با VRAM متوسط کافی باشد، اما مدلهای بزرگ، Fine-tuning و برخی پروژههای LLM به GPUهایی با ظرفیت VRAM بالاتر نیاز دارند. بنابراین هنگام انتخاب GPU، فقط قدرت پردازشی آن را بررسی نکنید و ظرفیت VRAM را نیز در نظر بگیرید.
CPU؛ چه پردازندهای برای AI مناسب است؟
اگرچه در بسیاری از workloadهای AI بخش اصلی محاسبات بر عهده GPU است، CPU همچنان نقش مهمی در آمادهسازی داده، اجرای سرویسها، مدیریت سیستم و هماهنگی با GPUها دارد.
انتخاب CPU باید بر اساس نوع workload و تعداد GPUها انجام شود. در سرورهای چندGPU، پردازنده باید توان کافی برای تغذیه GPUها و مدیریت همزمان سایر وظایف سیستم را داشته باشد.
RAM؛ چه مقدار حافظه سیستم نیاز داریم؟
RAM برای بارگذاری Dataset، آمادهسازی داده، اجرای سرویسهای AI و انجام همزمان چند پردازش مورد استفاده قرار میگیرد. مقدار موردنیاز به حجم داده و نوع workload بستگی دارد.
برای پروژههایی که با Datasetهای بزرگ یا چند سرویس همزمان کار میکنند، ظرفیت RAM بیشتر میتواند اهمیت زیادی داشته باشد. بنابراین بهتر است RAM بر اساس نیاز واقعی پروژه و امکان توسعه آینده انتخاب شود.
Storage؛ SSD یا NVMe؟
سرعت Storage در پروژههای AI، بهخصوص هنگام کار با Datasetهای حجیم، اهمیت دارد. SSD برای بسیاری از پروژهها عملکرد مناسبی ارائه میدهد، در حالی که NVMe SSD به دلیل سرعت و تأخیر پایینتر میتواند برای بارهای کاری سنگین و دسترسی مکرر به داده گزینه مناسبتری باشد.
علاوه بر سرعت، ظرفیت Storage نیز باید بر اساس حجم Dataset، مدلها، Checkpointها و خروجیهای تولیدشده تعیین شود. در برخی پروژهها نیز میتوان از ترکیب Storage پرسرعت برای دادههای فعال و ظرفیت ذخیرهسازی بیشتر برای آرشیو استفاده کرد.
Network؛ چه زمانی شبکه پرسرعت اهمیت پیدا میکند؟
در یک سرور مستقل، سرعت شبکه ممکن است اهمیت کمتری نسبت به GPU و Storage داشته باشد؛ اما در محیطهایی که سرور AI به Storage خارجی، سرورهای دیگر یا چند نود پردازشی متصل است، شبکه میتواند به یک عامل مهم در عملکرد کل زیرساخت تبدیل شود.
هرچه حجم انتقال Dataset و اطلاعات بین سرورها بیشتر باشد، انتخاب کارت شبکه و پهنای باند مناسب اهمیت بیشتری پیدا میکند.
Power و Cooling
GPU های قدرتمند و پردازندههای سروری میتوانند توان و حرارت قابلتوجهی تولید کنند. بنابراین هنگام طراحی کانفیگ AI باید توان مصرفی کل قطعات، ظرفیت منبع تغذیه و قابلیت خنکسازی سرور با یکدیگر هماهنگ باشند.
در کانفیگهای چندGPU، این موضوع اهمیت بیشتری پیدا میکند؛ زیرا علاوه بر تأمین توان کافی، جریان هوای مناسب و سیستم خنکسازی سازگار با GPUهای انتخابشده نیز باید در نظر گرفته شود.
انتخاب مدل سرور HP برای هوش مصنوعی
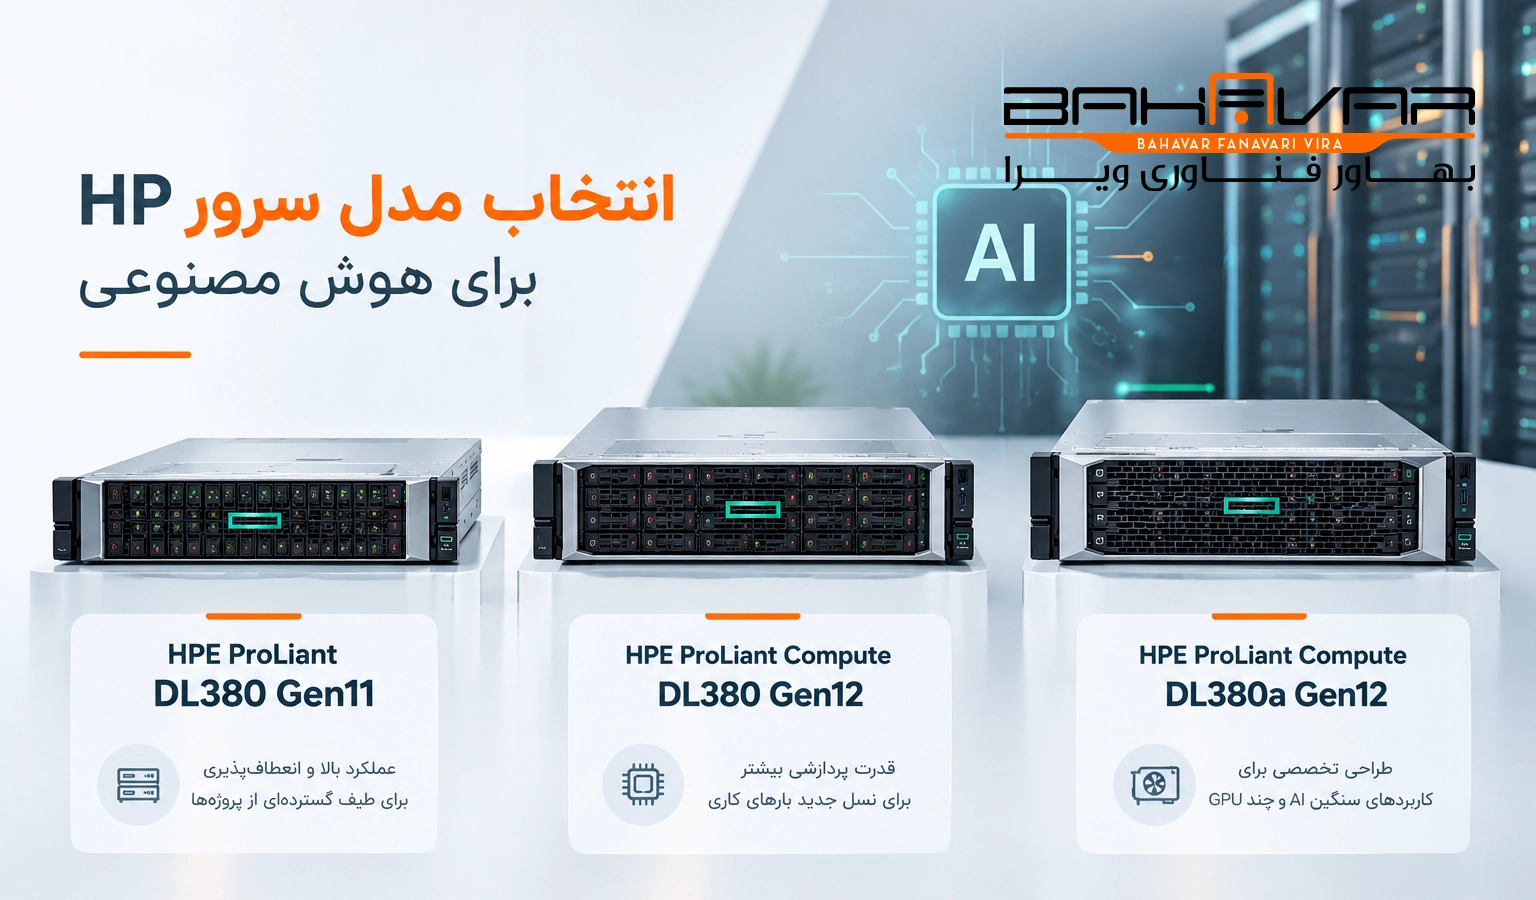
- HPE ProLiant DL380 Gen11
- HPE ProLiant Compute DL380 Gen12
- HPE ProLiant Compute DL380a Gen12
کانفیگهای پیشنهادی سرور HP برای هوش مصنوعی
کانفیگ مناسب سرور AI باید بر اساس نوع workload، اندازه مدل و حجم داده انتخاب شود. موارد زیر نمونههایی از کانفیگهای پیشنهادی هستند و میتوانند با توجه به نیاز پروژه، تعداد کاربران و بودجه تغییر کنند.
کانفیگ سرور HP برای AI Inference
برای اجرای مدلهای آموزشدیده، معمولاً سرعت پاسخ و تعداد درخواستهای همزمان اهمیت زیادی دارد. برای Inference سبک تا متوسط، نیازی نیست همیشه از GPUهای بسیار قدرتمند استفاده شود.
- مدل سرور: HPE ProLiant DL380 Gen11
- CPU: دو پردازنده Intel Xeon Scalable متناسب با workload
- GPU پردازنده گرافیکی: NVIDIA L40S 48GB یا NVIDIA L4 24GB
- VRAM حافظه ویدئویی: 24 تا 48GB برای هر GPU
- RAM: حداقل 128GB و در پروژههای بزرگتر 256GB یا بیشتر
- Storage ذخیره ساز: SSD NVMe برای سیستم و مدلها
- Network: شبکه 10/25GbE، متناسب با تعداد درخواستها و زیرساخت
- کاربرد: اجرای مدلهای AI، سرویسدهی به مدلهای آماده، چتبات، APIهای هوش مصنوعی و Inference سازمانی
کانفیگ سرور HP برای Computer Vision
در پروژههای بینایی ماشین، GPU برای پردازش تصاویر و ویدئو اهمیت زیادی دارد. تعداد دوربینها، وضوح تصاویر و پردازش Real-time در تعیین منابع موردنیاز تأثیرگذار هستند.
- مدل سرور: HPE ProLiant DL380 Gen11
- CPU: دو پردازنده Intel Xeon Scalable
- GPU پردازنده گرافیکی: NVIDIA L40S 48GB
- VRAMحافظه ویدئویی: 48GB
- RAM حافظه: 256GB
- Storage ذخیره ساز: NVMe SSD با ظرفیت مناسب Dataset و ویدئوها
- Network کارت شبکه : 25GbE برای محیطهای پردازش و انتقال داده سنگین
- کاربرد: تشخیص اشیا، تشخیص چهره، تحلیل ویدئو، کنترل کیفیت تصویری و پردازش تصاویر
کانفیگ سرور HP برای RAG و LLM
در RAG، علاوه بر اجرای مدل، بازیابی اطلاعات از منابع داده و پردازش Embedding و Vector Database نیز اهمیت دارد. بنابراین CPU، RAM و Storage در کنار GPU باید متناسب با حجم داده انتخاب شوند.
- مدل سرور: HPE ProLiant DL380 Gen12
- CPU: دو پردازنده Intel Xeon 6 متناسب با workload
- GPU پردازنده گرافیکی: NVIDIA L40S 48GB؛ برای مدلهای بزرگتر، GPU با VRAM بالاتر
- VRAM حافظه ویدئویی: 48GB یا بیشتر
- RAM حافظه: 256GB تا 512GB
- Storage ذخیره ساز: NVMe SSD با ظرفیت بالا برای مدلها، Vector Database و Dataset
- Network کارت شبکه: 25/100GbE در محیطهای متصل به Storage یا سرورهای دیگر
- کاربرد: RAG سازمانی، LLM، چتباتهای مبتنی بر اسناد، جستوجوی هوشمند و سرویسهای هوش مصنوعی داخلی
کانفیگ سرور HP برای Fine-tuning
Fine-tuning مدلهای بزرگ به GPU و VRAM بیشتری نسبت به بسیاری از کاربردهای معمول AI نیاز دارد. انتخاب GPU باید بر اساس اندازه مدل و روش Fine-tuning انجام شود.
- مدل سرور: HPE ProLiant Compute DL380a Gen12
- CPU: دو پردازنده Intel Xeon 6
- GPU پردازنده گرافیکی: NVIDIA H200 NVL 141GB یا H100 NVL 94GB
- VRAM حافظه ویدئویی: 94 تا 141GB برای هر GPU
- RAM: حداقل 512GB؛ برای مدلها و Datasetهای بزرگ، ظرفیت بالاتر
- Storage: چند NVMe SSD پرسرعت با ظرفیت مناسب
- Network کارت شبکه: 100GbE یا بالاتر، بهخصوص در زیرساخت چندسروری
- کاربرد: Fine-tuning مدلهای زبانی، مدلهای مولد و پروژههای Deep Learning سنگین
کانفیگ سرور HP برای AI سنگین و Multi-GPU
برای پروژههای سنگین AI که به چند GPU نیاز دارند، باید سروری انتخاب شود که از نظر فضای GPU، توان مصرفی، خنکسازی، PCIe و حافظه با این نوع workload سازگار باشد. در این سناریوها HPE ProLiant Compute DL380a Gen12 گزینه تخصصیتری نسبت به یک سرور عمومی است.
- مدل سرور: HPE ProLiant Compute DL380a Gen12
- CPU: دو پردازنده Intel Xeon 6 با تعداد هسته متناسب با workload
- GPU: چند NVIDIA H200 NVL یا NVIDIA RTX PRO 6000 Blackwell Server Edition
- VRAM: بسته به GPU انتخابی؛ H200 NVL دارای 141GB و RTX PRO 6000 Blackwell Server Edition دارای 96GB حافظه GPU است
- RAM: حداقل 512GB و برای کانفیگهای چندGPU سنگین، 1TB یا بیشتر
- Storage: چند NVMe SSD پرسرعت برای Dataset، Model و Checkpointها
- Network کارت شبکه: 100GbE یا بالاتر برای انتقال سریع داده در محیطهای چندسروری
- کاربرد: آموزش و Fine-tuning مدلهای بزرگ، Generative AI، LLMهای بزرگ، پردازشهای سنگین Deep Learning و زیرساختهای Multi-GPU
مقایسه کانفیگ های پیشنهادی سرور HP برای هوش مصنوعی
| نوع کاربرد | AI Inference | Computer Vision | RAG و LLM | Fine-tuning |
| مدل سرور | HPE ProLiant DL380 Gen11 | HPE ProLiant DL380 Gen11 | HPE ProLiant DL380 Gen12 | HPE ProLiant Compute DL380a Gen12 |
| CPU | 2× Intel Xeon Scalable | 2× Intel Xeon Scalable | 2× Intel Xeon 6 | 2× Intel Xeon 6 |
| GPU | L4 یا L40S | L40S | L40S یا GPU با VRAM بالاتر | H200 NVL یا H100 NVL |
| VRAM | 24 تا 48GB | 48GB | 48GB+ | 94 تا 141GB |
| RAM | 128 تا 256GB+ | 256GB | 256 تا 512GB | 512GB+ |
| Storage | NVMe SSD | NVMe SSD | NVMe SSD | چند NVMe SSD |
| Network | 10/25GbE | 25GbE | 25/100GbE | 100GbE+ |
آیا یک سرور HP برای پروژه هوش مصنوعی کافی است؟
تعداد سرورهای موردنیاز در یک پروژه هوش مصنوعی به اندازه مدل، نوع workload، حجم داده و میزان پردازش موردنیاز بستگی دارد. بنابراین یک نسخه ثابت برای همه پروژهها وجود ندارد.
- Single-GPU: برای پروژههای سبک تا متوسط مانند برخی کاربردهای Inference، Computer Vision و مدلهای کوچکتر، یک سرور مجهز به یک GPU میتواند کافی باشد.
- Multi-GPU: در آموزش مدلهای بزرگ، Fine-tuning و برخی پروژههای LLM، استفاده از چند GPU در یک سرور میتواند عملکرد و ظرفیت پردازشی بیشتری فراهم کند.
- چند سرور: در پروژههای بسیار بزرگ، ممکن است پردازش بین چند سرور و چندین GPU توزیع شود تا منابع بیشتری در اختیار مدل قرار گیرد.
- نوع workload: نیاز سختافزاری Training سنگین با Inference معمولی یکسان نیست. Training معمولاً به منابع پردازشی و GPU بیشتری نیاز دارد، در حالی که در Inference عواملی مانند سرعت پاسخ و تعداد درخواستهای همزمان اهمیت بیشتری پیدا میکنند.
اشتباهات رایج هنگام کانفیگ سرور برای هوش مصنوعی
- انتخاب GPU بدون توجه به VRAM
- انتخاب GPU قدرتمند بدون بررسی Power و Cooling
- توجه نکردن به Storage
- انتخاب RAM کمتر از نیاز Dataset
- انتخاب CPU بدون توجه به GPU
- انتخاب یک کانفیگ صرفاً بر اساس قیمت
خرید سرور HP از بهاور فناوری ویرا
برای خرید سرورهای HPE نو و اورجینال، انتخاب کانفیگ متناسب با نیاز پروژه و دریافت مشاوره تخصصی، میتوانید روی بهاور فناوری ویرا حساب کنید. ارائه گارانتی و خدمات پس از فروش، مشاوره کانفیگ پیش از خرید و ارسال رایگان در تهران از مزایای خرید از ماست.
برای انتخاب و خرید سرور HP مناسب، با کارشناسان بهاور فناوری ویرا در ارتباط باشید.
شماره تماس: 000 265 41 – 021
بهترین سرور hp برای هوش مصنوعی کدام است؟
بهترین مدل به نوع پروژه، اندازه مدل، تعداد gpu و میزان پردازش موردنیاز بستگی دارد. مدلهایی مانند DL380 G11، DL380 G12 و DL380a G12 بسته به نوع workload گزینههای قابل بررسی هستند.
برای هوش مصنوعی GPU مهمتر است یا CPU؟
در بسیاری از پروژههای ai، gpu نقش اصلی در پردازش محاسبات موازی و اجرای مدلها دارد؛ اما cpu نیز برای آماده سازی داده، اجرای سرویسها و هماهنگی با gpu اهمیت دارد.
چه مقدار RAM برای سرور AI نیاز داریم؟
مقدار حافظه به حجم داده، نوع مدل و تعداد سرویسهای همزمان بستگی دارد. برای بسیاری از پروژههای متوسط 128 تا 256 گیگابایت نقطه شروع مناسبی است و پروژههای سنگین ممکن است به 512GB یا بیشتر نیاز داشته باشند.
برای LLM چه مقدار VRAM نیاز است؟
مقدار پردازنده ویدئویی به اندازه مدل، روش اجرا و نوع پردازش بستگی دارد. مدلهای بزرگتر و Fine-tuning معمولاً به GPUهایی با VRAM بالاتر یا چند GPU نیاز دارند.
آیا DL380 Gen11 برای AI مناسب است؟
بله، HPE DL380 G11 با پشتیبانی از GPU های شتابدهنده میتواند برای کاربردهایی مانند Inference، Computer Vision و برخی پروژههای LLM و AI مناسب باشد.
DL380 Gen12 برای چه پروژههایی مناسب است؟
HPE Compute DL380 G12 برای پروژههای AI و پردازشی جدیدتر، از جمله LLM، RAG، پردازش داده و کاربردهایی که به توان پردازشی و توسعهپذیری بالاتری نیاز دارند، گزینه قابل بررسی است.
چه زمانی به سرور Multi-GPU نیاز داریم؟
زمانی که یک GPU از نظر VRAM یا توان محاسباتی برای workload کافی نباشد، مانند آموزش مدلهای بزرگ، Fine-tuning سنگین یا برخی پروژههای LLM، استفاده از چند GPU میتواند ضروری یا بهینهتر باشد.